文章摘要
这篇文章描述了用户在处理一个约1500M的Base64文本文件时遇到的问题。用户需要将该文件分割成多个较小文件(每次50M左右)分别进行转换,但由于使用的小工具存在安全问题(如病毒或崩溃)以及转换后的文件需要额外处理,用户自行开发了一个名为V1.001的工具。该工具支持以下特点:最大可支持2G文件、最多可分割成9999个文件、按字节定义分割文件大小、自定义缓存大小以避免内存不足或溢出。此外,文章附带了一个Python脚本供参考。
我有1个约1500M的Base64文本文件,需要转换成二进制文件,但一次转换这么大的文件,内存吃不消,所以就想要分割成50M左右的多个文件,每个文件单独转换;网上找了几个小工具,很多居然带病毒;
另外几个只要超过100M,就崩溃了;用RAR等工具转换后,还得删掉文件头尾被RAR附加的额外数据,只好自己造轮子了,写了这个工具;
V1.001
更新内容:
1、增加了执行时长显示;
2、去掉了对comdlg32.ocx的依赖,没有这个ocx也可以使用。
特点:
1、最大可支持2G的文件(即限制:合并后的文件,或者分割前的文件小于2G)
2、最多可分割成9999个文件
3、可以按字节定义分割文件大小
4、可以自定义缓存大小,避免内存不足或溢出。
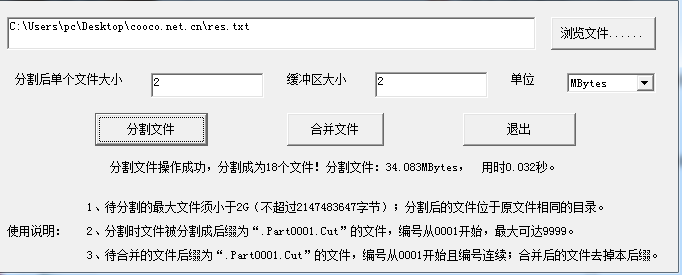
附送另外一个python写的: 不过得需要环境库 喜欢省事的还是直接花2元下载exe直接运行的吧
if __name__ == "__main__":
    path="E:\\download\\测试数据.txt"
    with open(path,"rb") as fp:
        # 设置分割的大小,单位k
        size=300
        size=size*1024
        # 开始位置
        start=0
        # 读取的最终位置
        end=0
        # 计数器
        i=1
        byte=b"0"
        while byte!=b"":
            # 设置指针位置,主要是为了查找指针后面\n的位置,这个操作简称为“寻值”
            fp.seek(end+size,0)
            byte=fp.read(1)
            i+=1
            # 寻值
            while byte!=b"\n" and byte!=b"":
                byte=fp.read(1)
            end=fp.tell()
            # 存入文件
            with open("E:\\download\\a\\1\\"+str(i*1)+".txt","wb") as fp1:
                fp.seek(start,0)
                fp1.write(fp.read(end-start))
                start=end